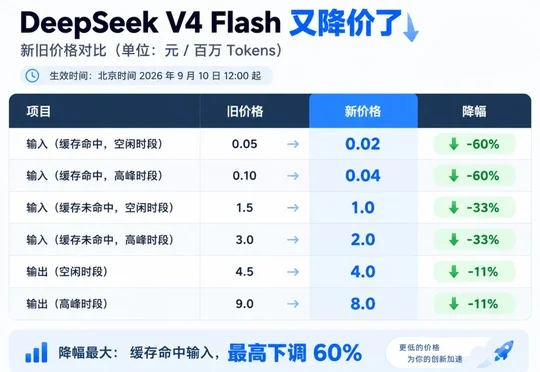
梁文锋听劝,DeepSeek把价格降回来了
梁文锋听劝,DeepSeek把价格降回来了DeepSeek Flash系列自明日中午起降价,闲时缓存、输入和输出价格分别降至每百万Token 0.02元、1元和4元,新模型DeepSeek v4.1 Flash也已上线。
来自主题: AI资讯
8632 点击 2026-09-09 10:30

 搜索
DeepSeek Flash系列自明日中午起降价,闲时缓存、输入和输出价格分别降至每百万Token 0.02元、1元和4元,新模型DeepSeek v4.1 Flash也已上线。
DeepSeek 突然上线限时内测模型 DeepSeek V4.1 Flash,采用新模型结构并原生支持多模态,在生成速度、使用成本和中文长文写作等实测中表现优于以往版本,DeepSeek 期望其在保持 Flash 速度与价格优势的同时,能力向 V4 Pro 靠拢。
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
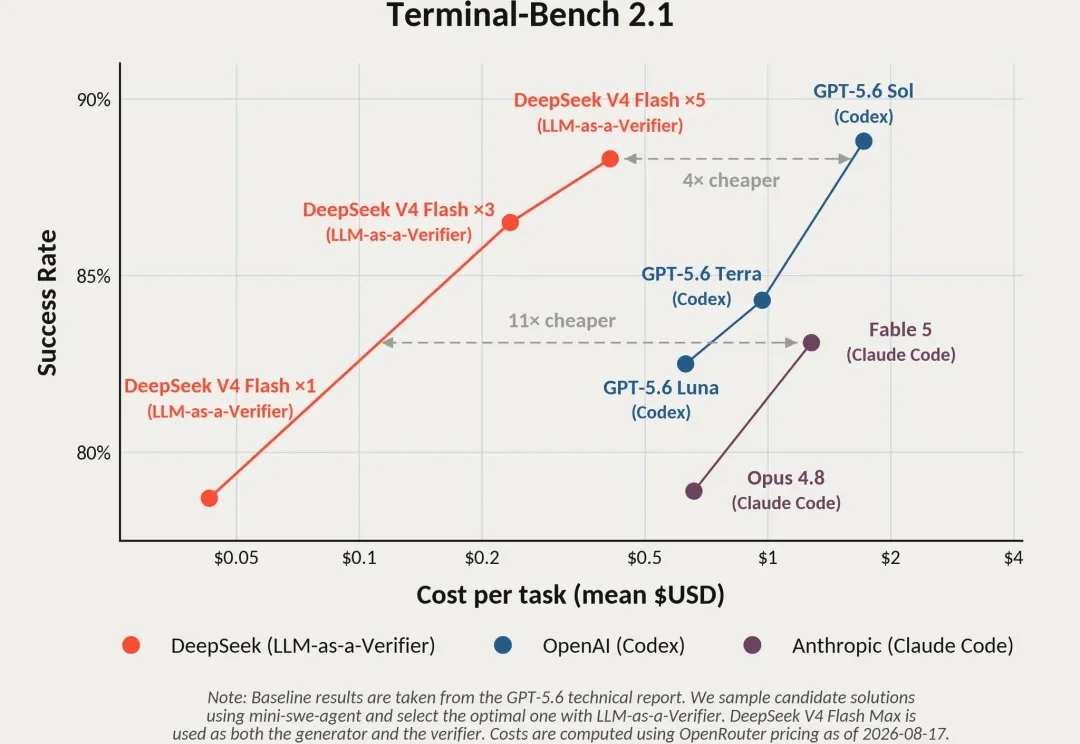
随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。
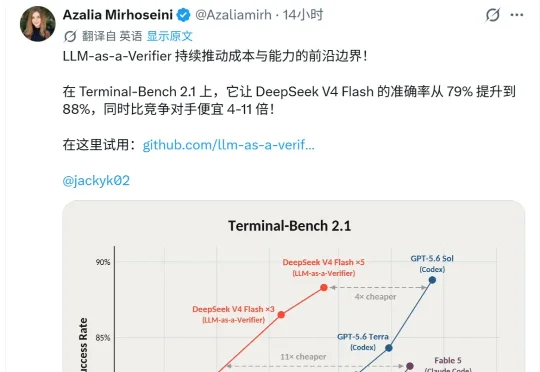
同样的模型,同样的任务,让它执行五遍,再让他自己挑一遍最稳的,效果能有多大提升?斯坦福把这套玩法用在了AI身上,DeepSeek V4 Flash在Terminal-Bench 2.1的成绩从79%一路涨到88%,反超了尖子生Fable 5。而且连做五遍加挑选这一通折腾,价格依然比Fable 5便宜了4-11倍。
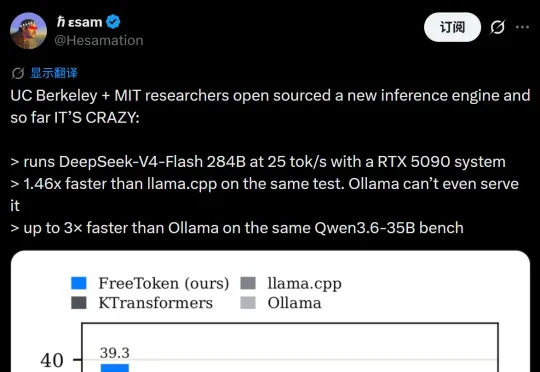
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
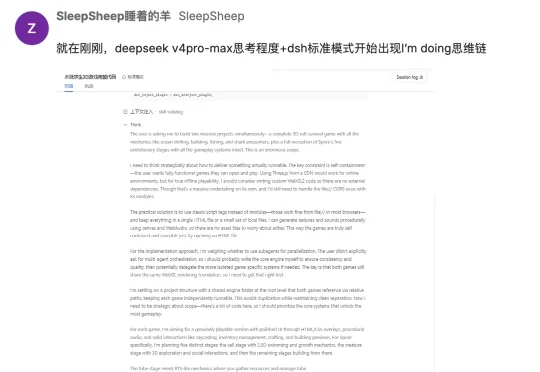
DeepSeek V4 Pro,可能又又又更新了。今天下午,有用户在技术社区 Linux.do 发帖称,自己在DeepSeek Harness标准模式、V4 Pro Max思考档位下,发现模型的思维链突然变了。
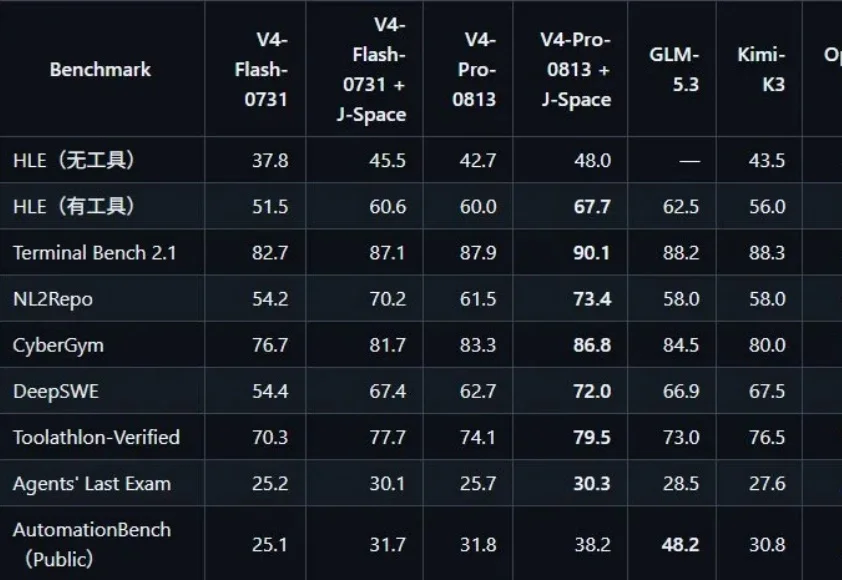
一个 Skill,就能让 DeepSeek V4 Pro 超过 Fable 5?
8月13日凌晨,DeepSeek V4 Pro正式登场,给开源模型生态又添一把猛火。从Kimi K3到MiniMax H3,再到DeepSeek V4 flash、DeepSeek V4 Pro,在中国开源模型的猛攻之下,美国的AI公司这次是真的坐不住了。
在昨天正式发布DeepSeek V4 Pro正式版之后。 预告了很久的,DeepSeek家自己的Agent产品终于也发出来了。 名字叫,DeepSeek Harness。 理念也很清晰,一切皆插件。 可能是有史以来最快的速度,截止到我写完文,它在Github上到了3万7的Star。